
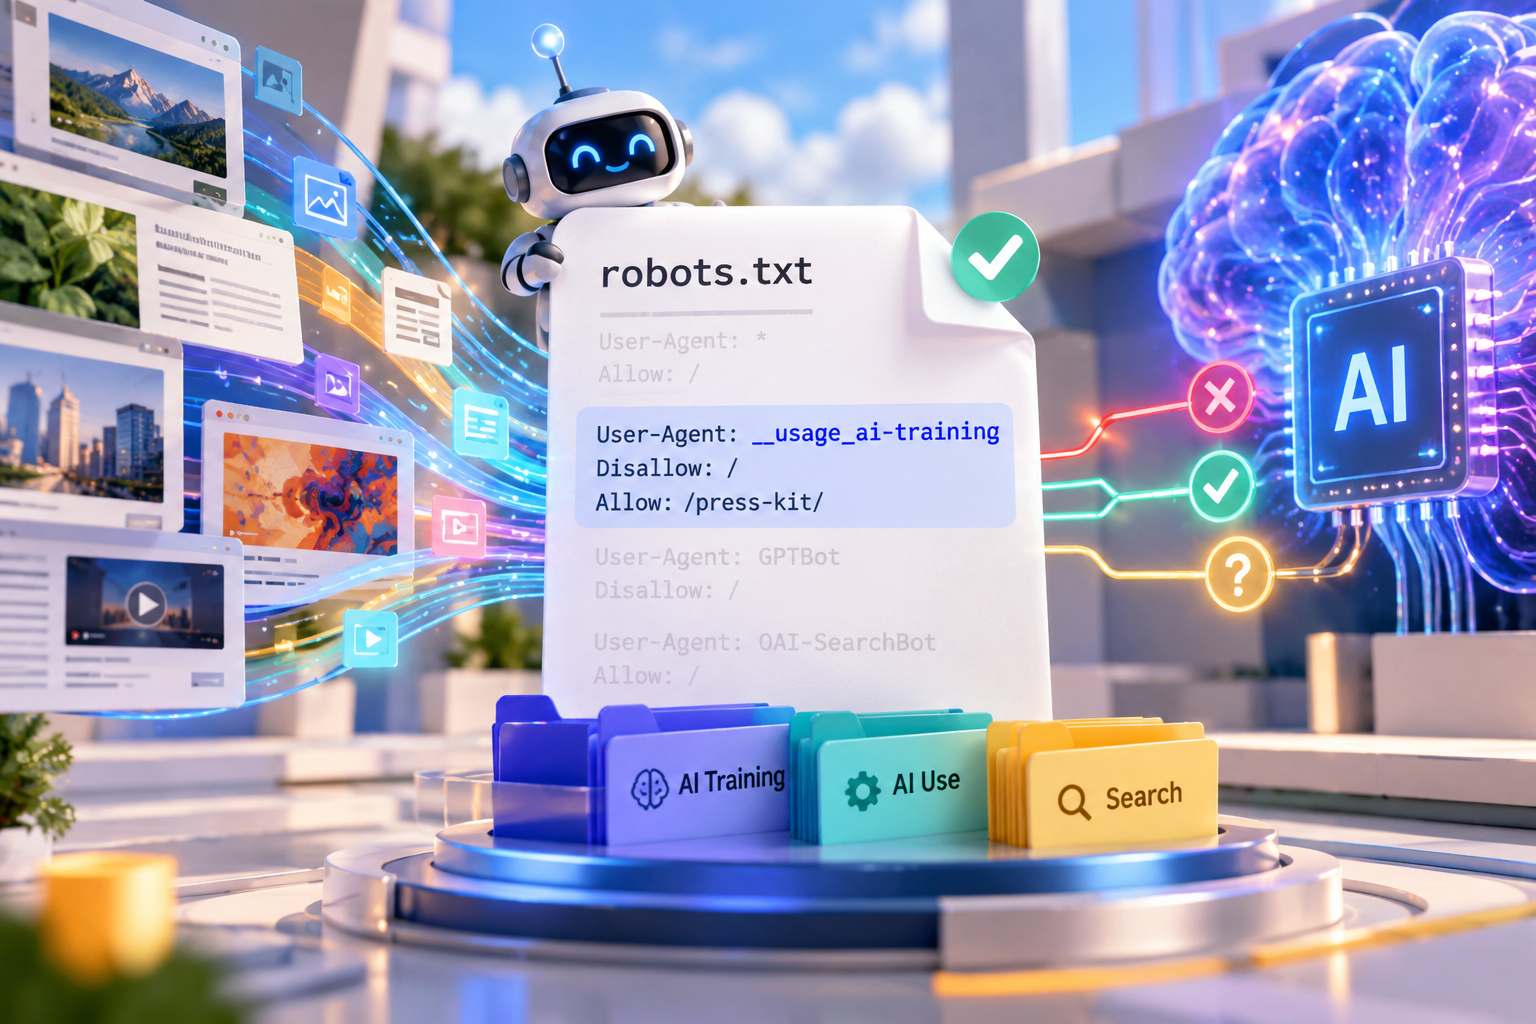
OpenAI ha annunciato la propria adesione a un meccanismo condiviso per esprimere, attraverso il file robots.txt, le preferenze dei gestori dei siti web sull’utilizzo dei contenuti nell’addestramento dei modelli di intelligenza artificiale. La soluzione prevede un segnale comune riconoscibile da più fornitori aderenti, superando la necessità di configurare esclusivamente regole separate per ciascun crawler. L’iniziativa si inserisce nelle attività dell’AI Preferences Working Group dell’Internet Engineering Task Force, impegnato nella definizione di modalità interpretabili automaticamente per comunicare le preferenze relative agli impieghi dei contenuti digitali. OpenAI ha dichiarato che intende implementare il nuovo segnale nei prossimi mesi, mantenendo nel frattempo operativi i controlli già disponibili attraverso robots.txt e continuando a rispettare le configurazioni esistenti. Il meccanismo è volontario e consente agli editori, ai proprietari dei siti e agli amministratori delle piattaforme web di comunicare un’unica preferenza sull’addestramento AI a più operatori che scelgano di supportarlo, senza richiedere l’introduzione di un formato completamente distinto per le dichiarazioni di utilizzo dei contenuti.
La proposta tecnica è descritta nel documento Machine-Readable Training Preference Signal, identificato come draft-kelley-aipref-training-preference-signal-00, redatto da Kevin Kelley di Anthropic e datato 30 ottobre 2026, con scadenza prevista il 3 maggio 2027. Il documento introduce il token condiviso __usage_ai-training, utilizzabile all’interno dei gruppi User-Agent del file robots.txt per associare una preferenza di impiego a specifici percorsi del sito. L’impostazione proposta mantiene la sintassi e le regole di interpretazione definite dallo standard RFC 9309, senza introdurre nuove direttive o modificare i criteri di precedenza dei percorsi. Un gestore può, per esempio, utilizzare User-Agent: __usage_ai-training insieme a Disallow: / e Allow: /press-kit/ per esprimere una preferenza contraria all’utilizzo dei contenuti per l’addestramento AI, mantenendo un’eccezione per la cartella dedicata ai materiali stampa. Il token identifica una finalità d’uso e non un crawler tradizionale: per questo motivo, un gruppo generico User-Agent: * non deve essere interpretato come una dichiarazione applicabile automaticamente alla preferenza di addestramento. Qualora il token non compaia nel file, il sistema considera la preferenza non espressa. I parser robots.txt che non riconoscono il nuovo meccanismo continuano a interpretare le regole di gestione del crawling secondo il comportamento preesistente.
Il segnale distingue esplicitamente le preferenze sull’utilizzo dei contenuti dalle istruzioni tecniche relative alla scansione del sito. La dichiarazione contraria all’addestramento AI non rappresenta quindi necessariamente un divieto di accesso da parte di qualsiasi crawler e non modifica automaticamente le regole che disciplinano l’indicizzazione o il recupero delle pagine. Il meccanismo è collegato al documento A Vocabulary For Expressing AI Usage Preferences, sviluppato da Paul Keller di Open Future e Martin Thomson di Mozilla, che definisce categorie separate per AI Training, AI Use e Search. La prima riguarda l’utilizzo di contenuti per modificare i parametri appresi di un modello generativo, escludendo i sistemi addestrati esclusivamente per attività non generative; la seconda si riferisce all’impiego di risorse come input per modelli generativi quando non siano state fornite direttamente dall’utente; la terza comprende le applicazioni il cui scopo principale consiste nel selezionare risorse e indirizzare gli utenti verso le rispettive posizioni. Per ciascuna categoria sono previsti valori equivalenti a consentito, vietato o sconosciuto, con applicazione della preferenza più restrittiva in presenza di dichiarazioni contrastanti. La documentazione specifica inoltre che eventuali accordi privati possono prevalere sulle preferenze espresse mediante il meccanismo e che la pubblicazione di una dichiarazione non costituisce, di per sé, una garanzia tecnica del suo rispetto.
Il nuovo sistema non sostituisce le modalità con cui OpenAI distingue attualmente le attività dei propri agenti automatizzati. GPTBot rimane il crawler associato alla raccolta di contenuti per l’addestramento dei modelli; OAI-SearchBot viene utilizzato per rendere disponibili le informazioni dei siti nelle funzioni di ricerca di ChatGPT, mentre OAI-AdsBot verifica le pagine sottoposte per l’utilizzo negli annunci pubblicitari e non destina i dati raccolti all’addestramento dei modelli generativi di base. ChatGPT-User gestisce invece alcune visite alle pagine attivate direttamente dagli utenti, per le quali le normali istruzioni robots.txt potrebbero non applicarsi nelle stesse modalità del crawling automatico. Un amministratore può quindi permettere la presenza delle pagine nei risultati di ricerca di ChatGPT attraverso OAI-SearchBot e, contemporaneamente, negare l’accesso per l’addestramento mediante GPTBot. Le modifiche alle impostazioni di ricerca possono richiedere circa 24 ore per produrre effetti. Il nuovo token condiviso si aggiungerà a questo sistema quando sarà completata l’implementazione annunciata. La proposta rimane attualmente un Internet-Draft individuale, privo di approvazione formale come standard IETF, e la sua applicazione dipenderà dall’adozione volontaria da parte dei diversi fornitori di tecnologie AI.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI).