
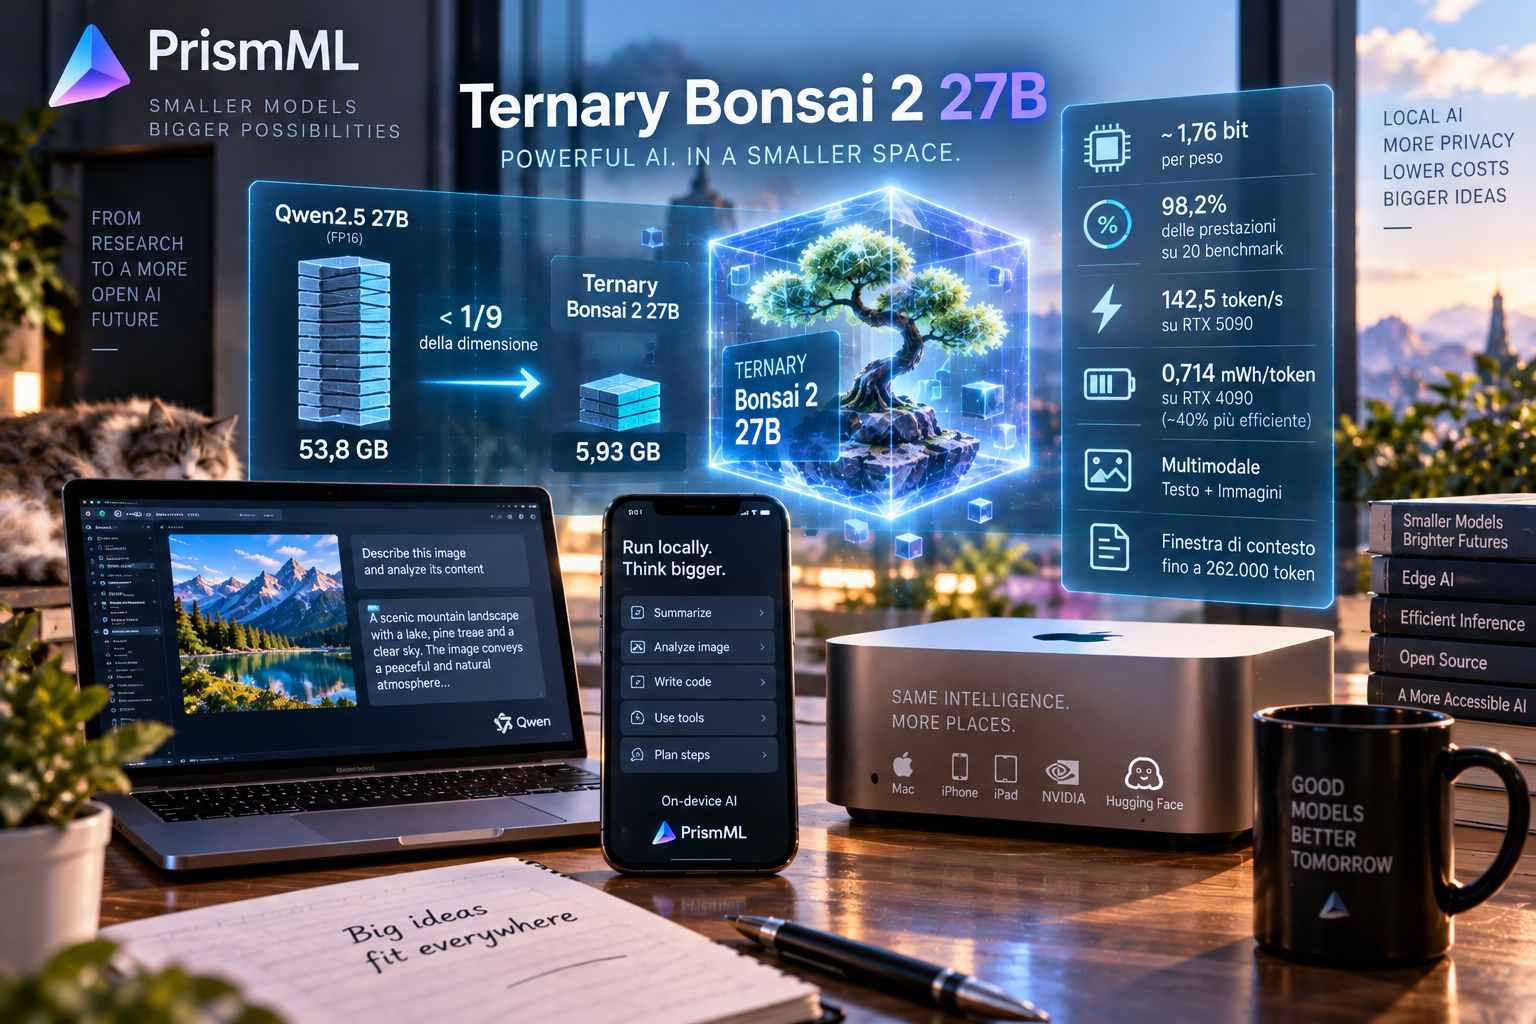
PrismML, startup nata come spin-off del California Institute of Technology, ha presentato Ternary Bonsai 2 27B, una nuova versione del proprio sistema di compressione per modelli linguistici di grandi dimensioni progettata per ridurre drasticamente l’occupazione di memoria senza compromettere in modo significativo le prestazioni. Il modello parte da Qwen2.5 27B di Alibaba, che in formato FP16 richiederebbe circa 53,8 GB, e ne riduce la dimensione fino a 5,93 GB, portando quindi l’uso di memoria a meno di un nono rispetto alla configurazione originale. La tecnica utilizzata sostituisce gran parte dei pesi a 16 bit con valori ternari limitati a -1, 0 e +1 e combina questa rappresentazione con uno scaling di gruppo in FP16, ottenendo uno spazio effettivo di circa 1,76 bit per peso. Dei 27,36 miliardi di parametri complessivi, la maggior parte viene così rappresentata a bassa precisione, mentre solo alcune componenti, tra cui pesi di normalizzazione e stati specifici, vengono mantenute in formati più accurati per contenere la perdita di qualità.
Sul piano delle prestazioni, PrismML dichiara che Ternary Bonsai 2 27B conserva in media il 98,2% delle capacità del modello originale su un insieme di 20 benchmark, migliorando rispetto alla prima versione Bonsai 27B, che due mesi prima si attestava intorno al 95%. I test includono compiti di ragionamento, matematica, programmazione, instruction following, comprensione delle immagini e utilizzo di strumenti da parte di agenti. La compressione non produce però risultati uniformi in tutti gli scenari: nei workload agentici più complessi, che richiedono l’esecuzione concatenata di numerosi passaggi, rimane ancora un divario rilevante rispetto a Qwen2.5 27B. Su Terminal-Bench 2.1 il modello compresso ha ottenuto 52,8 punti contro 69,7 dell’originale, mentre su SWE-bench Verified ha raggiunto 60,8 punti rispetto agli 80,6 del modello non compresso. Il valore del 98,2% va quindi interpretato come media complessiva dei benchmark e non come equivalenza prestazionale in ogni singolo tipo di attività.
La riduzione della memoria è accompagnata da miglioramenti anche sul fronte della velocità di esecuzione e dell’efficienza energetica. Su una GPU Nvidia RTX 5090 Ternary Bonsai 2 27B ha raggiunto una velocità massima di 142,5 token al secondo, mentre su un sistema basato su Apple M5 Max ha registrato 46,8 token al secondo. Su RTX 4090 il consumo dichiarato è di 0,714 milliwattora per token, con un’efficienza energetica che PrismML indica come superiore di circa il 40% rispetto a quella di un modello FP16 da 8 miliardi di parametri. La possibilità di eseguire un modello da oltre 27 miliardi di parametri con un ingombro inferiore a 6 GB modifica soprattutto i requisiti hardware per l’inferenza locale, rendendo praticabile l’uso su sistemi che normalmente non potrebbero ospitare un modello di queste dimensioni e riducendo al tempo stesso la necessità di trasferire continuamente dati verso infrastrutture cloud.
Ternary Bonsai 2 27B è inoltre un modello multimodale, capace di ricevere sia input testuali sia immagini, e supporta finestre di contesto fino a 262.000 token. Può essere eseguito in ambiente Nvidia attraverso CUDA e su Mac, iPhone e iPad mediante il framework MLX di Apple, estendendo quindi l’utilizzo della stessa architettura a dispositivi molto diversi per capacità di calcolo e memoria disponibile. Le possibili applicazioni indicate comprendono agenti per la programmazione, analisi di documenti e sistemi in grado di controllare direttamente un computer, ambiti nei quali l’elaborazione locale può offrire vantaggi in termini di latenza, privacy dei dati e minore dipendenza dalla connessione con servizi remoti. I pesi del modello sono stati pubblicati su Hugging Face con licenza Apache 2.0, consentendone quindi l’utilizzo e la sperimentazione anche al di fuori dell’infrastruttura della società.
PrismML aveva già attirato attenzione a luglio, quando era riuscita a ridurre un modello da 54 GB a meno di 4 GB e a eseguirlo su un iPhone 17 Pro, un risultato che aveva alimentato indiscrezioni su possibili valutazioni di acquisizione o collaborazione da parte di Apple e di altre grandi aziende tecnologiche. Con Ternary Bonsai 2 27B l’azienda mostra una versione più matura dello stesso approccio, puntando non soltanto alla riduzione estrema dell’occupazione di memoria, ma anche al mantenimento di una quota molto elevata delle prestazioni originarie. Il risultato rafforza soprattutto la possibilità di spostare modelli di dimensioni finora tipiche dei server verso l’esecuzione locale, con un compromesso che resta evidente nei task agentici più complessi ma che, per molte attività di inferenza, riduce in modo sostanziale i requisiti di memoria e consumo.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)