
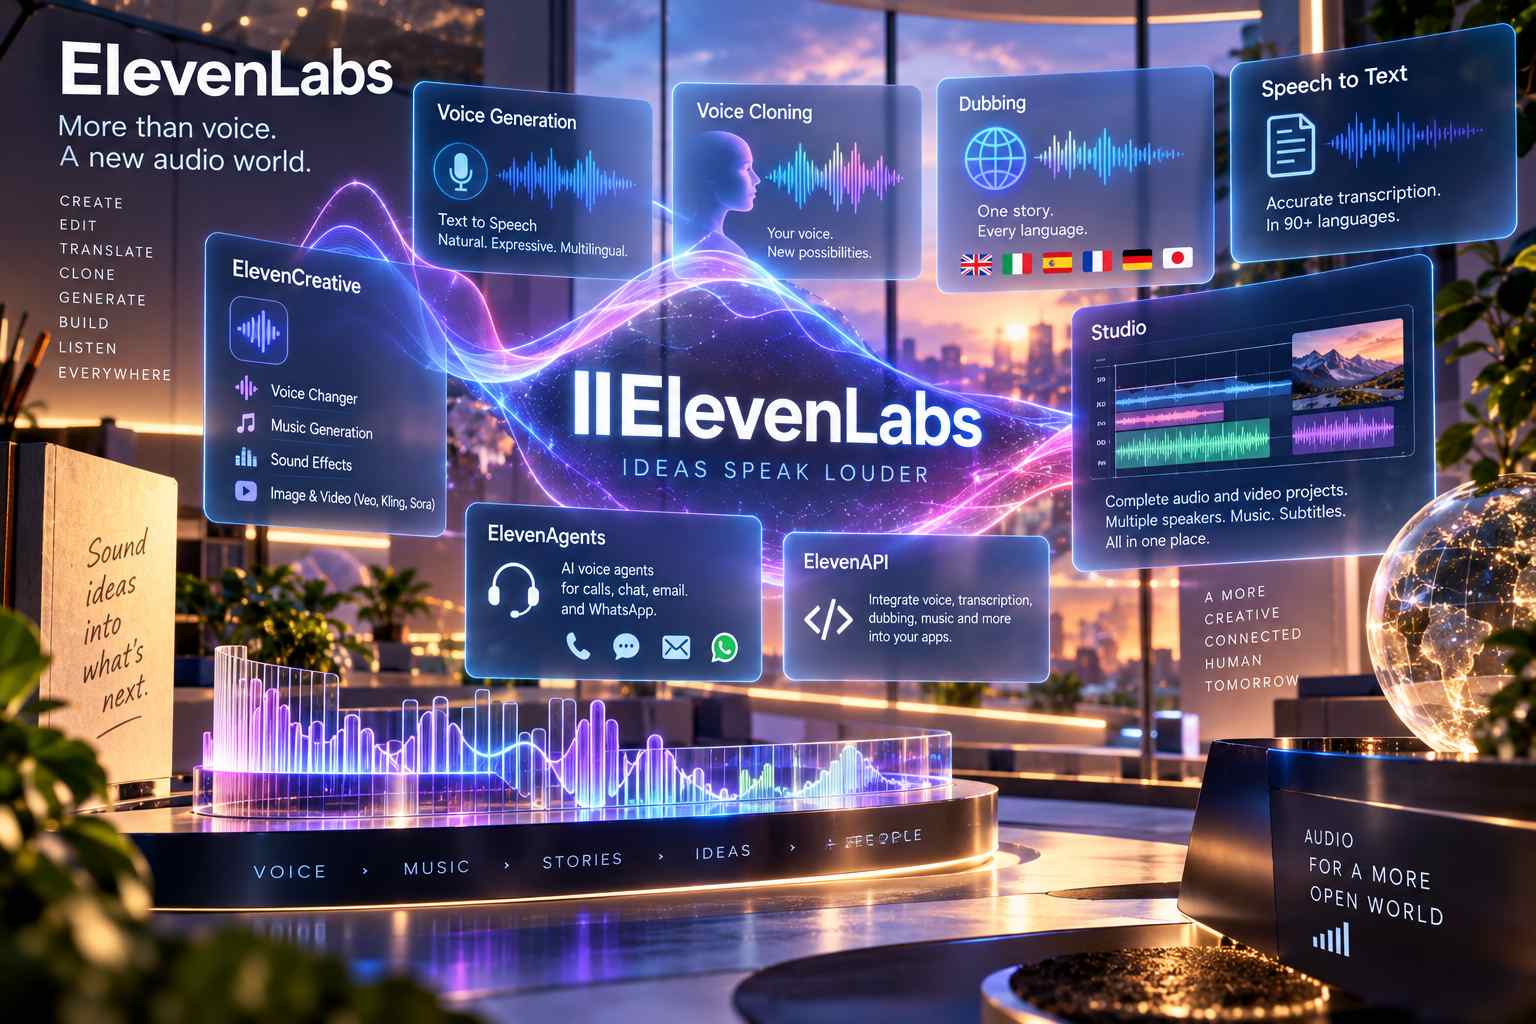
ElevenLabs si è evoluta da piattaforma specializzata nella sintesi vocale a un ambiente molto più ampio per la produzione e l’elaborazione di contenuti audio tramite intelligenza artificiale. Fondata nel 2022 da Mati Staniszewski, CEO, e Piotr Dąbkowski, CTO, la società ha lanciato la propria piattaforma in beta nel gennaio 2023 concentrandosi inizialmente sul text-to-speech. Nel 2026 ha raggiunto una valutazione di 11 miliardi di dollari e circa 500 milioni di dollari di ricavi ricorrenti annuali. L’offerta attuale comprende generazione vocale, clonazione della voce, conversione speech-to-speech, doppiaggio multilingue, trascrizione, generazione di musica ed effetti sonori, isolamento della voce, editing di progetti audio e strumenti destinati allo sviluppo di agenti vocali e applicazioni di terze parti.
La piattaforma è organizzata in tre aree principali. ElevenCreative costituisce l’ambiente destinato alla creazione dei contenuti e permette di inserire un testo, selezionare una voce e produrre il relativo file audio, affiancando al text-to-speech Voice Changer, doppiaggio, Speech to Text, generazione musicale ed effetti sonori. Studio integra invece in un unico editor timeline voce, più speaker, sottotitoli, musica ed effetti per la realizzazione di audiolibri, podcast e video. Sono presenti anche strumenti per generare immagini e video attraverso modelli di terze parti come Veo, Kling e Sora, ai quali possono essere aggiunti voiceover AI e sincronizzazione labiale. ElevenAgents è dedicato agli agenti conversazionali in grado di gestire telefonate e interazioni attraverso chat, email e WhatsApp, con particolare attenzione ai flussi di assistenza clienti e call center. ElevenAPI rende infine disponibili agli sviluppatori gli stessi sistemi di voce, trascrizione, musica e doppiaggio per l’integrazione all’interno di applicazioni, giochi e altri prodotti software.
Il modello Eleven v3 rappresenta la soluzione orientata alla generazione vocale più espressiva e supporta oltre 70 lingue, dialoghi con più interlocutori e tag inseriti direttamente nel testo per specificare elementi della performance come sussurri, risate, sospiri, rabbia o sarcasmo. Eleven Multilingual v2 supporta invece 29 lingue e mantiene un comportamento più stabile, particolarmente adatto alle narrazioni lunghe nelle quali la continuità della voce assume maggiore importanza rispetto alla componente espressiva. Per le applicazioni in tempo reale sono disponibili Flash v2.5, con una latenza indicativa di circa 75 millisecondi, e v3 Conversational, con una latenza nell’ordine dei 280 millisecondi.
La generazione vocale può partire da una libreria che comprende oltre 10.000 voci filtrabili in base ad accento, età, genere e caso d’uso oppure da Voice Design, che permette di descrivere tramite testo le caratteristiche desiderate, indicando per esempio età, accento, tono e tipologia del personaggio. La clonazione è disponibile nelle modalità Instant e Professional: la prima può creare una voce partendo da un breve campione audio, mentre la seconda utilizza una quantità maggiore di registrazioni e prevede un processo di verifica della voce. Voice Changer effettua invece una conversione speech-to-speech, sostituendo la voce registrata ma conservando elementi della performance originale come ritmo ed espressività.
Le differenze tra i modelli emergono anche nella generazione dello stesso voiceover. In una prova eseguita con la medesima voce e lo stesso testo, Eleven Multilingual v2 ed Eleven v3 hanno richiesto entrambi 449 crediti e tempi di elaborazione equivalenti. La versione v2 ha prodotto una voce realistica e naturale ma caratterizzata da un’intonazione tendenzialmente uniforme, mentre v3 ha restituito pause, inflessioni, pronuncia ed energia più articolate. Il risultato non ha richiesto correzioni o rigenerazioni, pur mantenendo alcune caratteristiche che possono consentire di riconoscere l’origine sintetica dell’audio.
Il maggiore controllo espressivo di v3 dipende anche dai performance tag, ma il loro comportamento non è sempre uniforme. In una generazione di un dialogo di circa otto battute tra due personaggi, contenente istruzioni come [whispers], [laughs], [sighs] e [angrily] e costata 581 crediti, diverse indicazioni sono state interpretate correttamente mentre altre sono state ignorate. In un caso la voce non ha rispettato l’istruzione di sussurrare, in un altro un personaggio che avrebbe dovuto apparire nervoso è risultato normale e sicuro, mentre un’istruzione relativa a una risata non è stata eseguita. L’interazione fra le due voci è risultata comunque sufficientemente naturale da poter essere impiegata in contenuti come podcast, dialoghi per videogiochi e produzioni audio narrative. Questa variabilità comporta però la possibile necessità di rigenerare singole battute, con un conseguente consumo aggiuntivo di crediti.
La clonazione istantanea consente di ottenere risultati utilizzabili partendo da registrazioni relativamente brevi. Con un campione pulito di uno-due minuti è possibile creare un Instant Voice Clone e utilizzarlo successivamente per pronunciare testi mai presenti nella registrazione originale. Nel confronto tra una registrazione reale e la relativa versione sintetica sono risultate riprodotte caratteristiche quali tono, accento, ritmo e respirazione, mentre la differenza più evidente ha riguardato una maggiore vivacità della versione generata. Una qualità di questo livello rende la funzione utilizzabile sia per produrre una narrazione sia per correggere parti specifiche di una registrazione senza dover incidere nuovamente l’intero contenuto.
Un’altra componente della piattaforma riguarda il doppiaggio automatico. Dubbing può tradurre contenuti audio e video in un’altra lingua cercando contemporaneamente di conservare la voce, il tono, l’emotività e il ritmo dell’oratore originale. In un test condotto su un video parlato in inglese della durata compresa tra 60 e 90 secondi e doppiato in spagnolo, la versione generata ha mantenuto in larga misura le caratteristiche vocali della persona, una traduzione coerente e un ritmo vicino a quello originale, producendo un risultato utilizzabile senza ulteriori modifiche. Il costo computazionale è però nettamente superiore a quello del normale text-to-speech: la generazione ha utilizzato 16.138 crediti, contro i 449 crediti impiegati per ciascuno dei voiceover utilizzati nel confronto fra v2 e v3.
Per la conversione inversa dall’audio al testo ElevenLabs utilizza Scribe v2, sistema di Speech to Text che supporta più di 90 lingue, può distinguere fino a 32 speaker e permette di fornire termini chiave per migliorare il riconoscimento di nomi e lessico specialistico. Una trascrizione effettuata su circa due minuti di audio contenente rumore di fondo e diversi nomi propri e termini tecnici ha mantenuto un’elevata accuratezza generale, mostrando tuttavia errori nella trascrizione di alcuni nomi. È disponibile anche una versione real-time destinata agli utilizzi dal vivo.
Studio riunisce in un unico progetto le diverse tecnologie della piattaforma e permette di costruire produzioni complete combinando voiceover, musica ed effetti. Nella realizzazione di un’introduzione per podcast di 60 secondi sono stati integrati una narrazione sintetica, una traccia musicale generata e due effetti sonori. La generazione della musica ha richiesto 900 crediti per minuto, mentre ciascun effetto sonoro ne ha utilizzati 17. Eleven Music può produrre da un prompt brani completi, comprese le parti vocali, e consente di selezionare una specifica sezione della traccia per rigenerarla senza dover ricreare l’intero brano; sui piani a pagamento i contenuti possono essere utilizzati commercialmente. Sound Effects genera invece effetti e ambientazioni sonore a partire da una descrizione testuale, mentre Voice Isolator rimuove dalla voce registrata rumori di fondo e riverbero.
La piattaforma comprende inoltre Iconic Marketplace, attraverso il quale vengono offerte versioni AI autorizzate di voci celebri sulla base di accordi con i titolari dei relativi diritti. Sul fronte della sicurezza, la creazione di un Professional Voice Clone richiede la verifica della voce e il sistema impedisce la clonazione di determinate personalità di alto profilo, distinguendo quindi la clonazione effettuata dall’utente dalle voci distribuite tramite licenza.
Nel complesso, le prove sui diversi strumenti evidenziano una generazione rapida e una buona continuità della voce fra paragrafi e generazioni successive. Voiceover, clonazione e doppiaggio possono produrre file utilizzabili con interventi limitati, mentre il principale elemento di variabilità riguarda il rispetto delle istruzioni espressive di v3. Anche la trascrizione può incontrare difficoltà con alcuni nomi propri. Il consumo dei crediti cambia inoltre sensibilmente in funzione dello strumento: una normale generazione vocale può richiederne poche centinaia, mentre il doppiaggio di un breve video può arrivare a diverse migliaia.
Il sistema dei crediti è condiviso tra le diverse funzioni della piattaforma e questo rende il consumo complessivo dipendente dal tipo di workflow adottato e dal numero di eventuali rigenerazioni. Il piano gratuito mette a disposizione 10.000 crediti al mese, equivalenti indicativamente a circa dieci minuti di parlato, senza richiedere una carta di credito, ma non comprende una licenza per l’uso commerciale dei contenuti né la clonazione vocale. La licenza commerciale è disponibile con i piani a pagamento, mentre il piano Starter non comprende la clonazione Professional. Per le esportazioni, l’MP3 è sufficiente per gli utilizzi ordinari, mentre i piani superiori rendono disponibili formati di qualità maggiore; il piano Pro consente inoltre l’output PCM a 44,1 kHz attraverso API.
Per gli sviluppatori ElevenLabs mette a disposizione API per text-to-speech, speech-to-text, doppiaggio, musica ed effetti sonori, insieme a SDK, interfaccia CLI e un server MCP ospitato. Le basse latenze dei modelli dedicati consentono di utilizzare la sintesi vocale anche in applicazioni interattive e agenti conversazionali. L’insieme degli strumenti copre così workflow molto diversi: dalla semplice conversione di uno script in voce alla produzione di audiolibri con più speaker, dal doppiaggio multilingue dei corsi alla creazione di dialoghi per videogiochi, fino alla trascrizione di podcast, alla correzione di registrazioni mediante voce clonata, alla produzione di annunci pubblicitari e alla realizzazione di agenti vocali per l’assistenza clienti.
Nel settore della sintesi vocale esistono piattaforme con impostazioni differenti. Murf è maggiormente orientata a voiceover professionali per presentazioni, formazione, dimostrazioni di prodotto ed explainer video e dispone di integrazioni con Canva e Google Slides. Speechify nasce soprattutto come sistema text-to-speech per l’ascolto di documenti, email e contenuti testuali su iPhone, Android, Mac, Chrome ed Edge, mentre Speechify Studio aggiunge voiceover, doppiaggio, editing e avatar AI. WellSaid utilizza invece una libreria di oltre 280 voci realizzate con doppiatori professionisti, prevalentemente in inglese al di fuori dei piani Enterprise, senza offrire clonazione vocale o voci caricate dalla community; include inoltre funzionalità SSO destinate agli ambienti aziendali. ElevenLabs concentra nello stesso ecosistema una gamma più ampia di funzioni, dalla sintesi espressiva e multilingue alla clonazione, dal doppiaggio alla trascrizione, fino alla generazione musicale e alla costruzione di applicazioni vocali tramite API.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)