
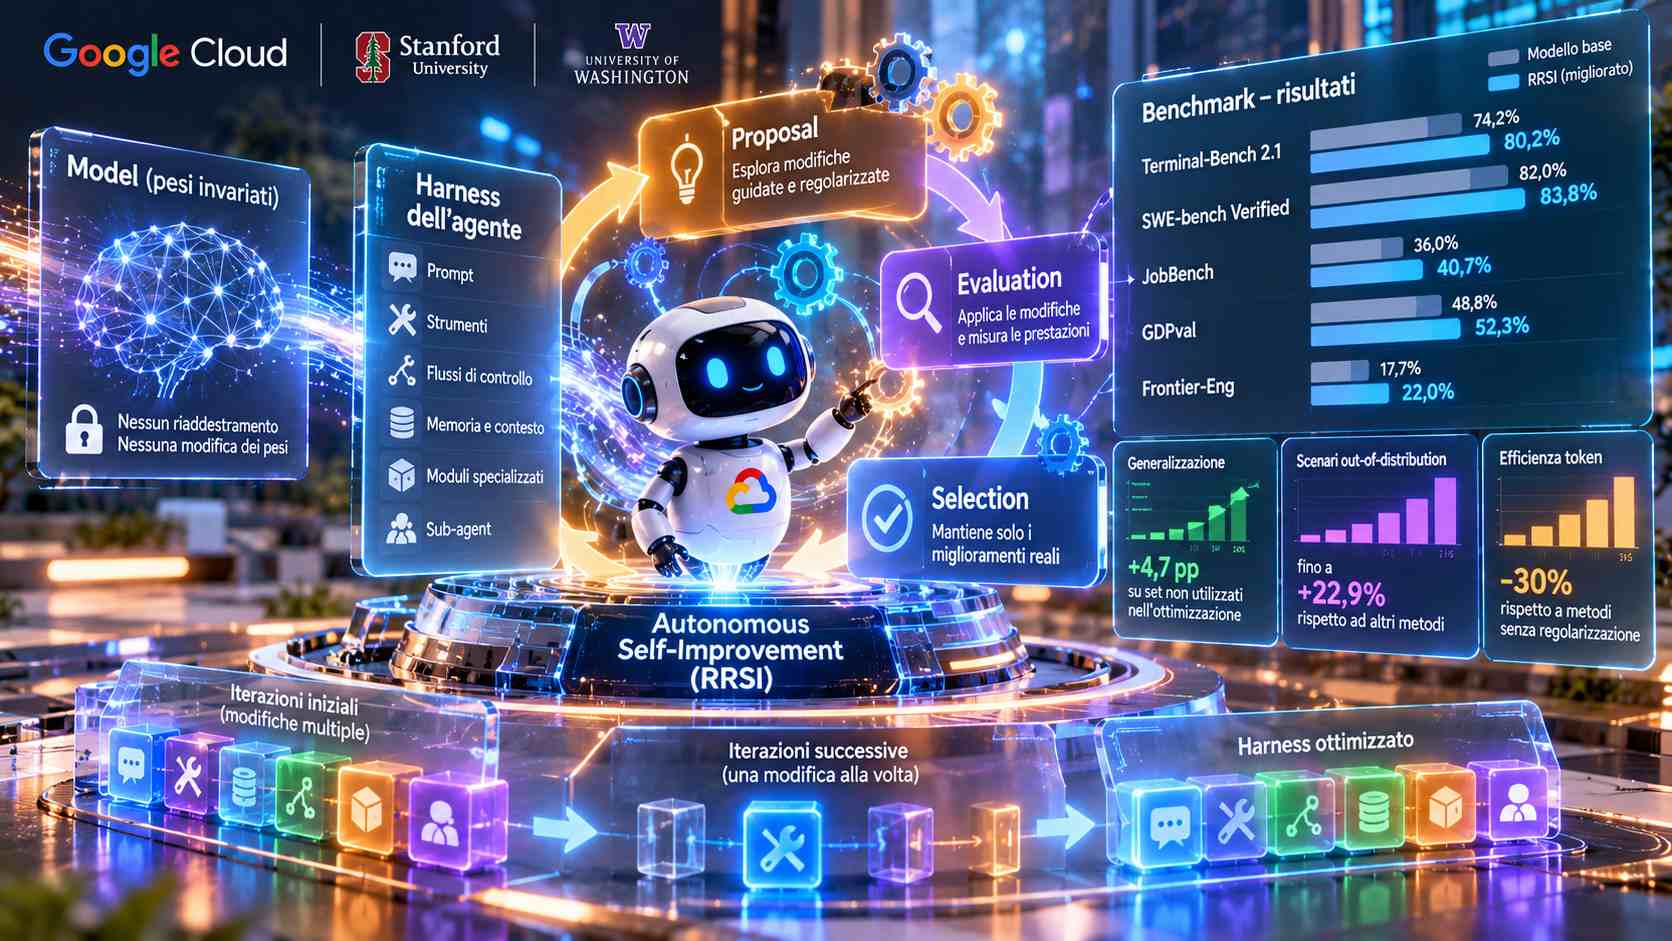
Google Cloud AI Research, insieme a ricercatori di Stanford University e University of Washington, ha presentato RRSI, Regularized Recursive Self-Improvement of Agent Harnesses, un framework che consente a un agente AI di migliorare progressivamente le proprie prestazioni senza modificare o riaddestrare i pesi del modello di base. Il sistema interviene invece sull’harness che circonda il modello, cioè sull’insieme composto da prompt, modalità di utilizzo degli strumenti, flussi di controllo, gestione della memoria e del contesto, moduli specializzati e sub-agent. L’agente genera modifiche al proprio ambiente operativo, le applica, ne misura gli effetti e conserva soltanto quelle che producono un miglioramento verificabile. RRSI utilizza una doppia struttura di regolarizzazione: nella fase di Proposal limita e indirizza l’esplorazione tenendo conto della cronologia delle modifiche già provate, così da evitare di ripetere soluzioni inefficaci e controllare le risorse utilizzate, mentre nella fase di Selection elimina il rumore delle valutazioni e mantiene solo gli interventi che producono un guadagno reale rispetto al costo computazionale aggiuntivo. Il numero di modifiche viene inoltre ridotto progressivamente: nelle prime iterazioni il sistema può alterare più elementi contemporaneamente per esplorare uno spazio ampio di possibilità, mentre nelle fasi successive tende a modificare un singolo componente alla volta, in modo da identificare con maggiore precisione l’origine del miglioramento e rimuovere eventuali elementi che abbiano smesso di essere utili. Questa struttura serve anche a limitare l’overfitting sui benchmark, evitando che il sistema impari semplicemente a sfruttare caratteristiche specifiche dei test invece di produrre modifiche generalizzabili.
Nei test condotti su otto benchmark, RRSI ha migliorato il punteggio di Terminal-Bench 2.1 dal 74,2% all’80,2%, con un aumento di 6 punti percentuali, mentre SWE-bench Verified è passato dall’82,0% all’83,8%, JobBench dal 36,0% al 40,7%, GDPval dal 48,8% al 52,3% e Frontier-Eng dal 17,7% al 22,0%. I ricercatori hanno osservato miglioramenti anche su cinque set di valutazione non utilizzati direttamente nel processo di ottimizzazione, con incrementi fino a 4,7 punti percentuali, mentre negli scenari out-of-distribution il sistema ha ottenuto prestazioni superiori fino al 22,9% rispetto ad altri metodi di evoluzione dell’harness. In un esperimento separato basato su Gemini 3.5 Flash, Terminal-Bench 2.1 è salito dal 64,6% al 78,7%, con un incremento di 14,1 punti percentuali, e SWE-bench Verified dal 76,8% al 79,0%. L’approccio ha mostrato anche una maggiore efficienza nell’uso dei token: in un test sull’agent workspace RRSI ha consumato circa 2,42 milioni di policy token per esperimento, contro i 3,8 milioni richiesti da un metodo di evoluzione dell’harness privo di regolarizzazione, con una riduzione superiore al 30%.
RRSI sposta quindi il processo di miglioramento dall’addestramento del modello alla configurazione del sistema che lo utilizza, permettendo di aumentare le capacità operative senza intervenire direttamente sui parametri del modello. L’obiettivo è trovare configurazioni dell’harness che non siano semplicemente ottimizzate per un singolo benchmark, ma mantengano i vantaggi anche su compiti esterni e condizioni non viste durante il processo di miglioramento. Il framework è attualmente destinato alla ricerca ed è stato pubblicato su GitHub con licenza Apache 2.0, consentendo a sviluppatori e ricercatori di analizzarne il codice e sperimentare ulteriori strategie di auto-ottimizzazione degli agenti.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)