
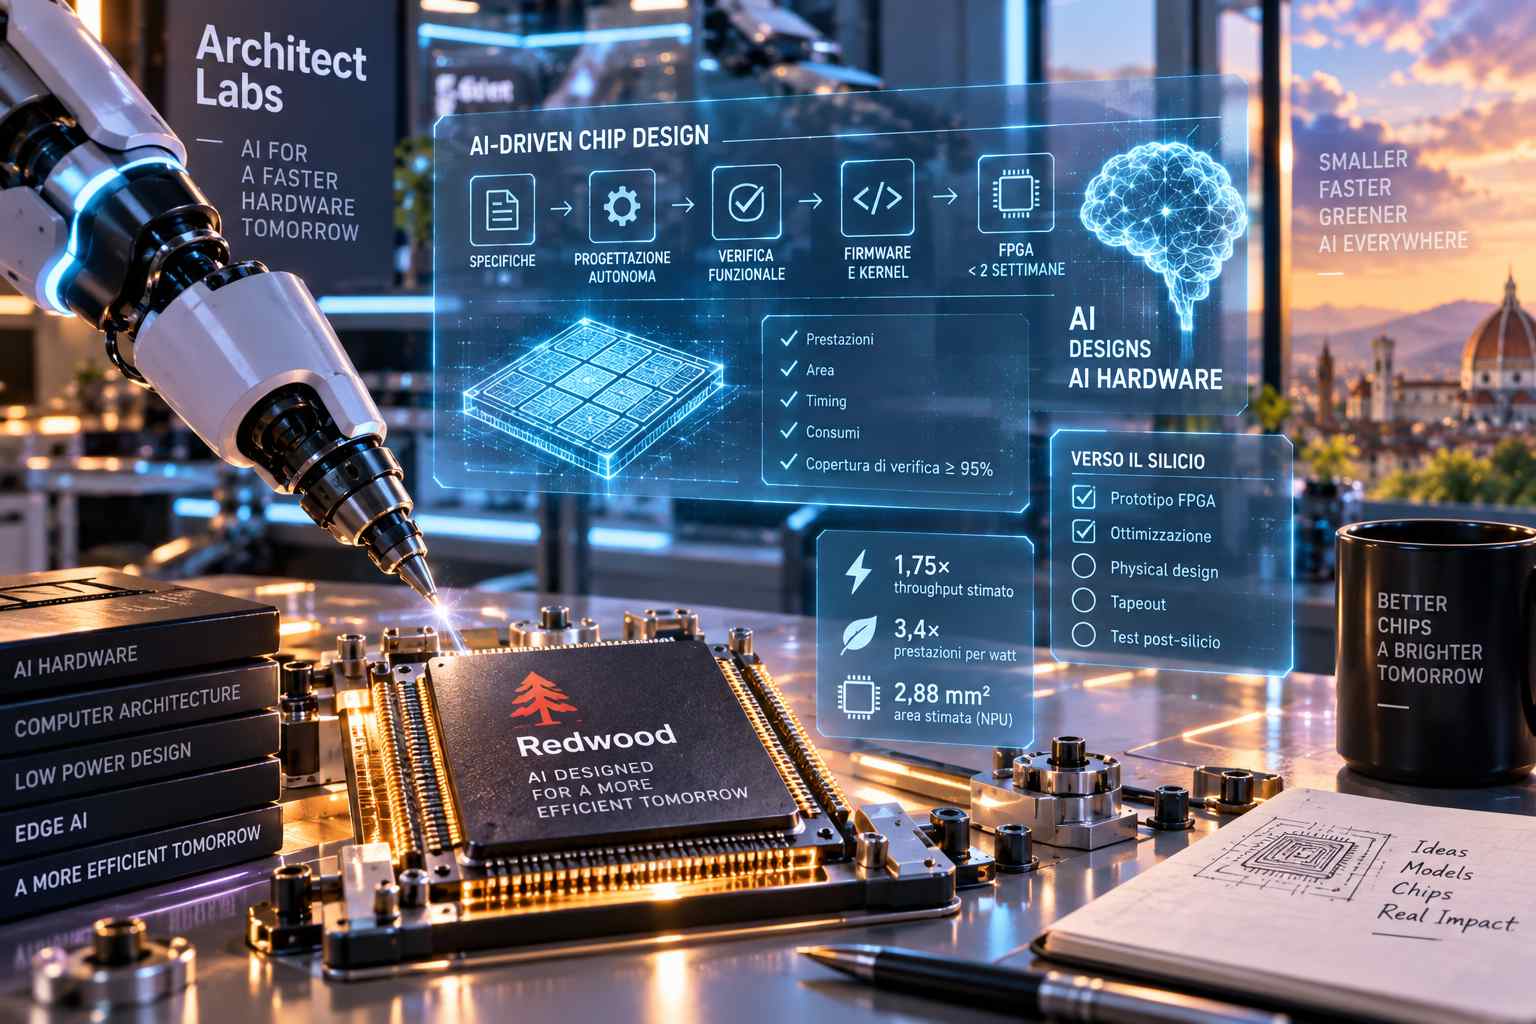
Architect Labs ha sviluppato Redwood, un acceleratore AI a basso consumo progettato quasi interamente da un sistema di intelligenza artificiale a partire da una specifica tecnica scritta da due architetti hardware. Dopo la definizione iniziale dei requisiti, la Architect Labs Platform ha gestito autonomamente la modellazione delle prestazioni, la generazione delle descrizioni digitali dell’hardware, la verifica funzionale, la produzione del firmware e lo sviluppo dei kernel necessari all’esecuzione. L’intero processo ha richiesto meno di due settimane, mentre una modifica della specifica già verificata poteva essere riportata su FPGA in meno di 48 ore. Il risultato resta per ora a livello sperimentale: Redwood è stato eseguito su FPGA e non è ancora stato fabbricato in silicio, quindi le prestazioni definitive del chip fisico dovranno ancora essere validate attraverso le successive fasi di physical design, tapeout e test post-silicio.
L’obiettivo di Architect Labs è affrontare uno dei problemi strutturali della progettazione dei chip per l’intelligenza artificiale: i modelli evolvono nell’arco di mesi, mentre un processore destinato a eseguirli viene progettato e congelato anni prima, obbligando i progettisti a fare previsioni su carichi di lavoro ancora inesistenti. Nei flussi tradizionali, inoltre, le diverse fasi vengono progressivamente consolidate e le modifiche tardive diventano costose oppure vengono rimandate alla generazione successiva. Secondo i dati citati dall’azienda, nel 2024 soltanto il 14% dei progetti di circuiti integrati e ASIC ha raggiunto il successo al primo silicio, mentre il 75% ha accumulato ritardi. Architect Labs punta quindi a sostituire una sequenza di fasi rigide con un ciclo unico nel quale hardware e software vengono progettati, verificati e ottimizzati contemporaneamente, consentendo ai progettisti umani di modificare la specifica sulla base dei risultati relativi a funzionalità, area, prestazioni, timing e consumi e di rigenerare rapidamente l’intero sistema.
Nel caso di Redwood, l’AI ha raggiunto almeno il 95% di copertura sia del codice sia delle funzionalità per ogni blocco senza l’intervento diretto di ingegneri umani nella verifica. Il primo design RTL trasferito dalla simulazione all’FPGA non avrebbe mostrato errori e lo spostamento delle iterazioni di ottimizzazione direttamente sull’FPGA ha ridotto i tempi di ciascun ciclo da circa 15 ore a 15-30 minuti. La piattaforma può inoltre esplorare uno spazio di possibili microarchitetture circa dieci volte più ampio di quello che un team umano riuscirebbe a valutare nello stesso intervallo di tempo. Nel progetto di uno dei motori vettoriali, per esempio, il sistema ha generato e verificato più varianti con differenti logiche di controllo e percorsi dei dati, ottimizzandole per area occupata e vincoli temporali nell’arco di alcuni giorni.
Redwood utilizza un’architettura organizzata in una griglia di tile identici, ciascuno incaricato di eseguire una parte specifica del calcolo e di trasferire i dati direttamente ai blocchi vicini. L’obiettivo è mantenere le informazioni il più vicino possibile alle unità di elaborazione, riducendo gli spostamenti verso memoria condivisa che rappresentano una delle principali fonti di latenza e consumo energetico. Il sistema separa inoltre la logica di controllo dalle unità di calcolo, permettendo a parti del chip di rallentare o spegnersi quando non vengono utilizzate, mentre il calcolo vicino alla memoria e la gestione del flusso sulla rete interna servono a diminuire ulteriormente l’energia spesa nel trasferimento dei dati. Un timer globale coordina infine l’esecuzione dei kernel per rendere più prevedibile il comportamento del processore.
Le misurazioni disponibili riguardano Redwood Nano, una variante eseguita su FPGA e confrontata con Nvidia Jetson Orin Nano come riferimento per l’edge AI. Sull’FPGA Redwood Nano ha raggiunto in media 12,1 token al secondo a 250 MHz eseguendo Qwen3 0.6B, mentre Jetson Orin Nano ha registrato 28 token al secondo a 1.020 MHz. Il vantaggio prestazionale indicato da Architect Labs emerge quindi soltanto nelle proiezioni relative a un’eventuale versione realizzata in silicio. Utilizzando un processo Samsung di classe 8 nanometri comparabile con quello del Jetson Orin Nano, i ricercatori stimano per Redwood Nano circa 49 token al secondo, pari a 1,75 volte il throughput misurato sul sistema Nvidia, con un consumo previsto di 1,335 watt contro 2,59 watt e quindi un miglioramento di circa 3,4 volte nelle prestazioni per watt. L’NPU occuperebbe inoltre soltanto 2,88 millimetri quadrati. Questi valori restano tuttavia proiezioni calibrate sui risultati FPGA e dovranno essere verificati su un chip fisicamente prodotto.
Architect Labs ha sperimentato anche un passaggio che definisce come una prima forma di recursive self-improvement, sebbene in un’accezione ancora molto limitata rispetto a un sistema autonomo capace di migliorare integralmente sé stesso. Qwen3 è stato eseguito su Redwood e reso disponibile come endpoint di inferenza all’interno della stessa piattaforma AI che aveva progettato l’acceleratore; il modello è stato quindi utilizzato ripetutamente per individuare miglioramenti nel timing e ottimizzazioni dei kernel relativi alle proprie operazioni. Si crea così un ciclo nel quale un sistema AI progetta l’hardware destinato a eseguire un modello, quel modello viene eseguito sul nuovo hardware e viene poi impiegato per migliorare una futura generazione dello stesso acceleratore. Architect Labs sta ora lavorando verso il tapeout di Redwood presso TSMC, passaggio necessario per verificare se il vantaggio ottenuto nell’ambiente FPGA possa essere trasferito a un processore reale.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)